0. 전체 지도영상 한 편에 AI 가 네 명 일한다 — 편집은 AI 가 아니다
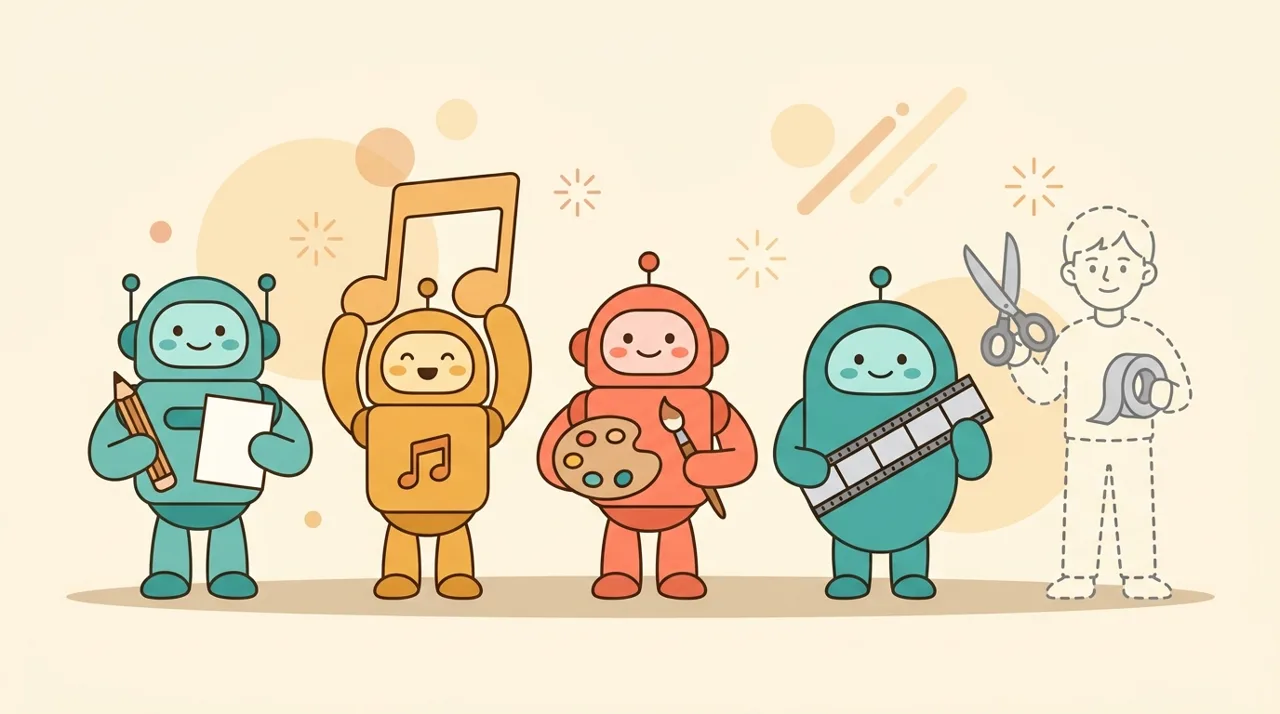
네 AI 는 하는 일이 달라 보여도 속으로는 전부 같은 질문을 풉니다 — 「다음에 뭐가 올까?」
「오늘 여러분 영상 한 편에 AI 가 스무 번 넘게 일해요. 가사 1번, 노래 1번, 그림 5장, 영상 여러 번. 그런데 이 넷은 사실 같은 놀이를 합니다 — ‘다음 것 맞히기’.」
이 장의 목표 — «AI 가 여러 개» + «편집은 AI 가 아니다» 두 가지만 남기면 성공. 네 AI 를 하나의 뿌리(다음 것 맞히기)로 묶는 것은 뒤 11장의 예고편이다.
📚 진짜 원리 (정확한 말로)
- 글 AI = 대형 언어 모델(LLM). 앱은 가사 초안·스타일 제안·5장면 나누기 세 번을 부른다. 1순위가 흔들리면 다른 회사 모델로 자동 대체된다.
- 음악 AI = 가사+스타일 문장을 받아 노래를 만드는 음악 생성 모델. 노래는 앱이 60초에서 자른다.
- 그림 AI = 장면 문장(+참고 그림)을 받아 16:9 그림을 내는 이미지 생성 모델. 컷마다 최대 3번까지 다시 시도한다.
- 영상 AI = 그림 한 장을 받아 5초 영상을 내는 image-to-video 모델. 실패하면 재시도 없이 그 컷만 실패한다.
- 편집실 = ffmpeg 라는 영상 도구. 줌·팬·전환·제목/끝 카드·음악 합치기 전부 «정해진 계산». 그래서 무료·즉시.
🗣️ 이렇게 진행
「여러분 영상 한 편에 AI 가 몇 번 일했을까요?」→ 손 들게 하고 세어 본다: 가사 1 · 스타일 1 · 장면 나누기 1 · 노래 1 · 그림 5(+재생성) · AI 영상 최대 5 ≈ 15~20번.
❓ 나올 질문과 답
- 「편집실도 AI 아니에요?」→ 아니다. 줌·팬은 «똑같은 입력 → 항상 똑같은 결과»인지 물어보면 구분된다(11장에서 다시).
- 「AI 가 다 하는데 내가 만든 거 맞아요?」→ 12장으로 미룬다. 지금은 「그 질문 기억해 두자」.
⚠️ 조심할 것
네 AI 의 실제 제품 이름은 학생에게 말하지 않는다(모델은 바뀐다). 「글 AI·음악 AI」로만 부른다.
A-1. 다음 것 맞히기글 AI 는 자판 «추천 낱말»을 엄청나게 키운 것
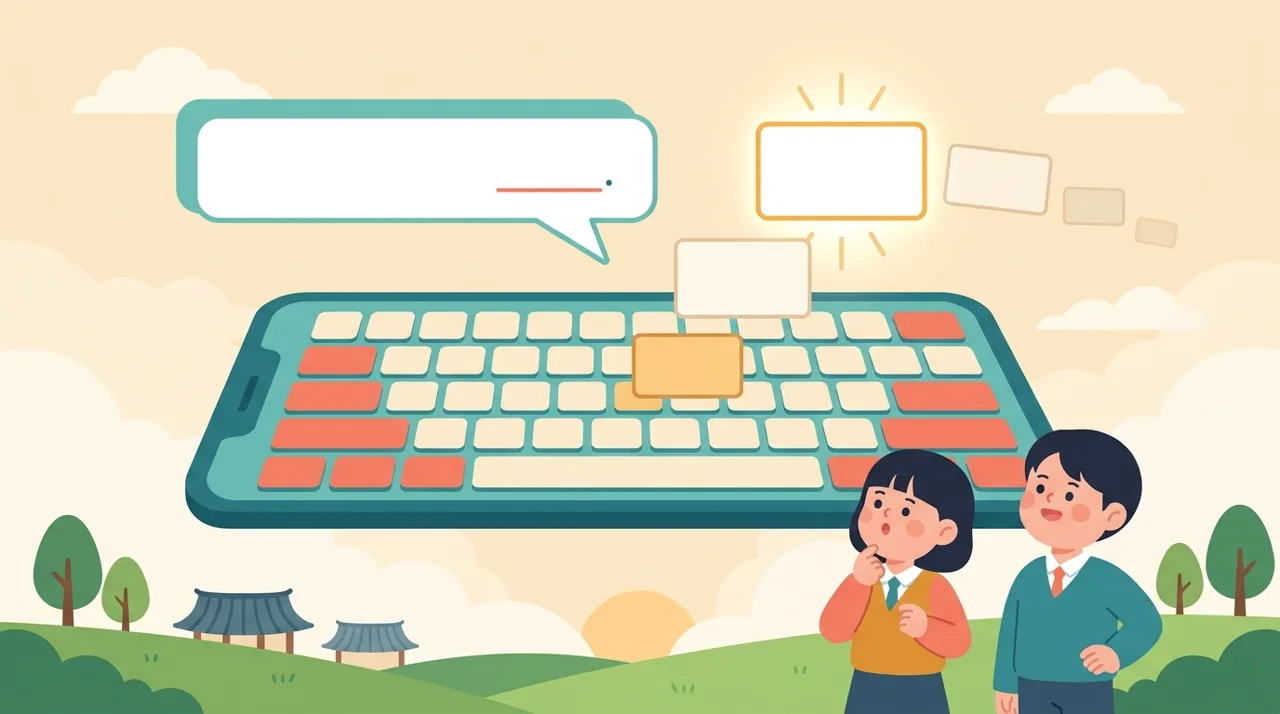
AI 는 글을 엄청나게 많이 읽어서 「이 말 뒤엔 보통 뭐가 오지?」를 압니다. 가사 한 편은 이 빈칸 채우기를 수백 번 한 결과예요.
「휴대폰 자판 위에 뜨는 추천 낱말 있죠? 그걸 세상의 글을 다 읽은 수준으로 키우면 글 AI 가 됩니다.」
이 장의 목표 — «AI 는 생각하는 게 아니라 다음 낱말을 확률로 고른다» 한 문장. 자판 추천 비유가 통하면 끝.
📚 진짜 원리 (정확한 말로)
- 정확한 이름: 다음 토큰 예측(next-token prediction). 토큰은 낱말보다 작은 조각(한국어는 대략 글자 1~2개).
- 모델은 인터넷 글 수조 개 토큰을 읽으며 «앞 문맥 → 다음 토큰 확률표»를 익혔다. 출력은 낱말 하나가 아니라 모든 후보의 확률 분포다.
- 하나 고르면 그것을 문맥에 붙이고 다시 다음을 고른다(자기회귀). 가사 12줄 ≈ 토큰 200~300개 = 이 과정 200~300번.
- 앱은 학생 주제를 지시문 안에 끼워 보낸다: 「초·중등 학생이 고쳐 쓸 수 있는 가사 초안 / 주제: ○○ / 60초 안 분량 8~12줄 / 가사만 출력」. AI 는 이 지시문 «뒤에 올 법한 글»을 쓴다.
🗣️ 이렇게 진행
칠판에 「운동장 끝에서 불어오는 ___」 쓰고 학생이 낱말을 외치게 → 많이 나온 순으로 크기를 다르게 적는다. 「이게 AI 머릿속 카드 크기예요.」 그다음 한 낱말을 고르고 다시 빈칸을 만든다 → 「이걸 300번 하면 가사.」
❓ 나올 질문과 답
- 「AI 가 뜻을 알고 쓰는 거예요?」→ 「뜻을 안다」는 논쟁 중인 질문. 수업 답: «뜻이 비슷한 말끼리 가까이 두는 지도는 있다(6장), 하지만 우리처럼 겪어서 아는 건 아니다».
- 「그럼 베끼는 거예요?」→ 특정 글을 그대로 외워 내는 게 아니라 «패턴»을 익힌 것. 단, 유명 가사는 통째로 나올 수 있어 앱은 원본 가사를 넣지 말라고 안내한다.
⚠️ 조심할 것
«생각하지 않는다»를 «멍청하다»로 잘못 전하지 말 것. 확률 예측이 이 정도 글을 쓴다는 것 자체가 놀라운 점이라고 덧붙인다.
A-2. 주사위다시 만들기를 누르면 왜 가사가 달라질까 — 주사위
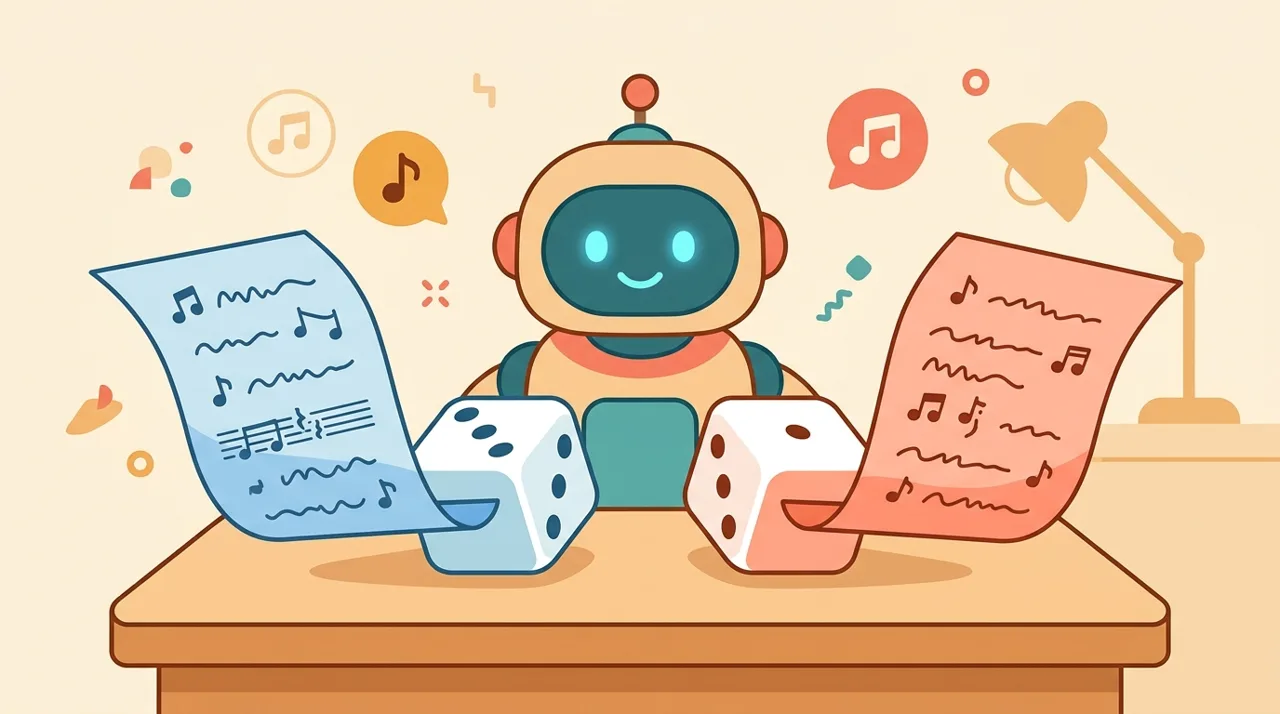
AI 는 1등 카드만 고르지 않고 주사위를 굴려 고릅니다. 그래서 다시 누르면 다른 가사가 나와요. AI 가 준 건 정답이 아니라 주사위 한 번의 결과입니다.
「마음에 안 들면 다시 굴려도 돼요. 하지만 내 경험 한 줄을 직접 넣는 순간 그건 진짜 내 노래가 됩니다.」
이 장의 목표 — «다시 만들기 = 주사위 다시 굴리기». 그래서 초안은 정답이 아니고, 고쳐 쓰기가 내 몫이라는 태도를 심는다.
📚 진짜 원리 (정확한 말로)
- 정확한 이름: 샘플링(sampling)과 온도(temperature). 1등만 고르면 «greedy», 확률대로 뽑으면 «sampling». 온도가 높을수록 작은 카드도 자주 뽑힌다.
- 같은 지시문이라도 매번 다른 결과가 나오는 건 고장이 아니라 설계다. 온도 0 으로 두면 거의 같은 글이 나오지만 뻔해진다.
- 앱은 결과를 그대로 쓰지 않고 검사한다 — 비어 있으면 실패 처리, 글자 수 상한을 넘으면 자른다, 욕설 목록에 걸리면 막는다.
🗣️ 이렇게 진행
학생 둘에게 같은 주제로 초안을 받게 하고 화면을 나란히 띄운다. 「같은 주제, 같은 AI, 다른 가사 — 왜?」 → 주사위. 이어서 「그럼 어느 게 정답?」 → 둘 다 아니다, 내가 고친 게 정답.
❓ 나올 질문과 답
- 「다시 만들기 몇 번까지 돼요?」→ 가사 초안은 제한 없지만 노래 생성은 5곡. «주사위 굴릴 기회»가 정해진 건 노래 쪽.
- 「좋은 게 나올 때까지 굴리면 되잖아요」→ 굴리기보다 고치기가 빠르다. 15분 안에 노래까지 가야 한다는 시간 압박을 상기.
⚠️ 조심할 것
«주사위»는 «완전 무작위»로 오해되기 쉽다. 「큰 카드가 자주, 작은 카드가 가끔」 — 확률에 비례한다는 말을 꼭 붙인다.
B-1. 소리도 점이다소리는 «점이 엄청 많은 그림» — 1초에 점 4만 개
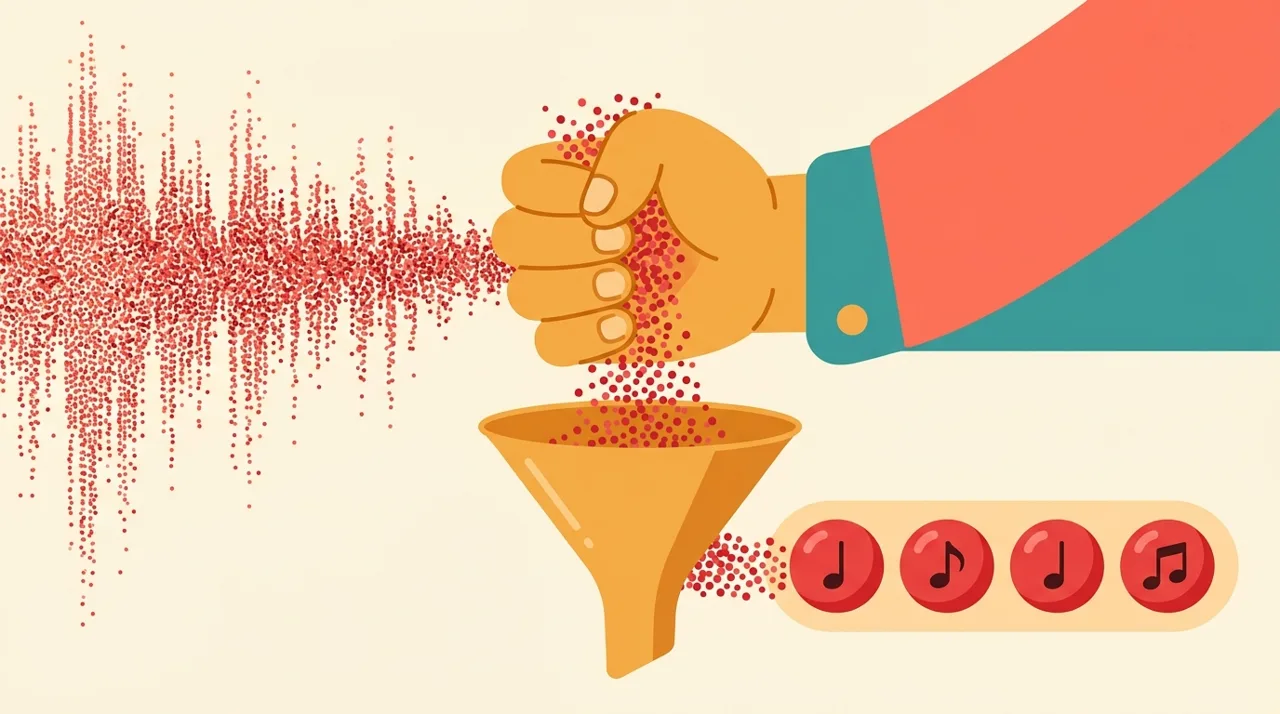
사진이 점(픽셀)으로 되어 있듯 소리도 점으로 되어 있어요. 너무 많아서 음악 AI 는 먼저 점을 뭉쳐 «조각»으로 줄입니다.
「1분 노래면 점이 265만 개예요. 하나씩 맞히긴 너무 많죠. 그래서 짧은 순간의 소리를 조각 하나로 뭉칩니다.」
이 장의 목표 — «소리도 숫자(점)다»와 «너무 많아서 뭉친다» 두 단계. 다음 장(레고 블록)의 바탕이 된다.
📚 진짜 원리 (정확한 말로)
- 디지털 소리 = 공기 압력을 1초에 44,100번 잰 숫자 줄(샘플링 레이트 44.1kHz, CD 규격). 앱이 받는 노래도 이 규격.
- 1분 = 약 265만 개. 글 AI 가 토큰 300개를 고르듯 하나씩 고르기엔 너무 많다.
- 그래서 음악 AI 는 먼저 오디오 코덱/토크나이저로 수십 분의 1초를 «조각(오디오 토큰)» 하나로 압축한다. 1초가 조각 수십 개로 줄어든다. 다 고른 뒤 다시 파형으로 펼친다(디코더).
- 과학 시간 «소리는 진동» 과 연결하면 좋다. 파형 그림 = 진동의 그래프.
🗣️ 이렇게 진행
휴대폰 음성 메모를 켜고 말하면서 파형이 그려지는 걸 프로젝터로 보여 준다. 「이 선 위의 점 하나하나가 숫자예요. 1초에 4만 개.」 그다음 「AI 가 이걸 하나씩 맞힐 수 있을까?」→ 뭉치기.
❓ 나올 질문과 답
- 「사진 점(픽셀)이랑 뭐가 달라요?」→ 사진은 자리마다 색 숫자, 소리는 시간마다 압력 숫자. 둘 다 숫자 덩어리라 AI 가 다룰 수 있다.
- 「왜 하필 4만 개예요?」→ 사람 귀가 듣는 가장 높은 소리(약 2만 Hz)의 두 배를 재야 원래대로 복원된다는 규칙(나이퀴스트). 중학생에겐 「귀가 듣는 것보다 넉넉하게」로 충분.
⚠️ 조심할 것
«점 4만 개»는 정확히 44,100. 슬라이드엔 «4만»으로 둥글렸다. 학생이 물으면 정확한 수를 말해 준다.
B-2. 다음 것 맞히기노래는 레고 블록 줄 — 앞 블록을 보고 다음 블록을 고른다
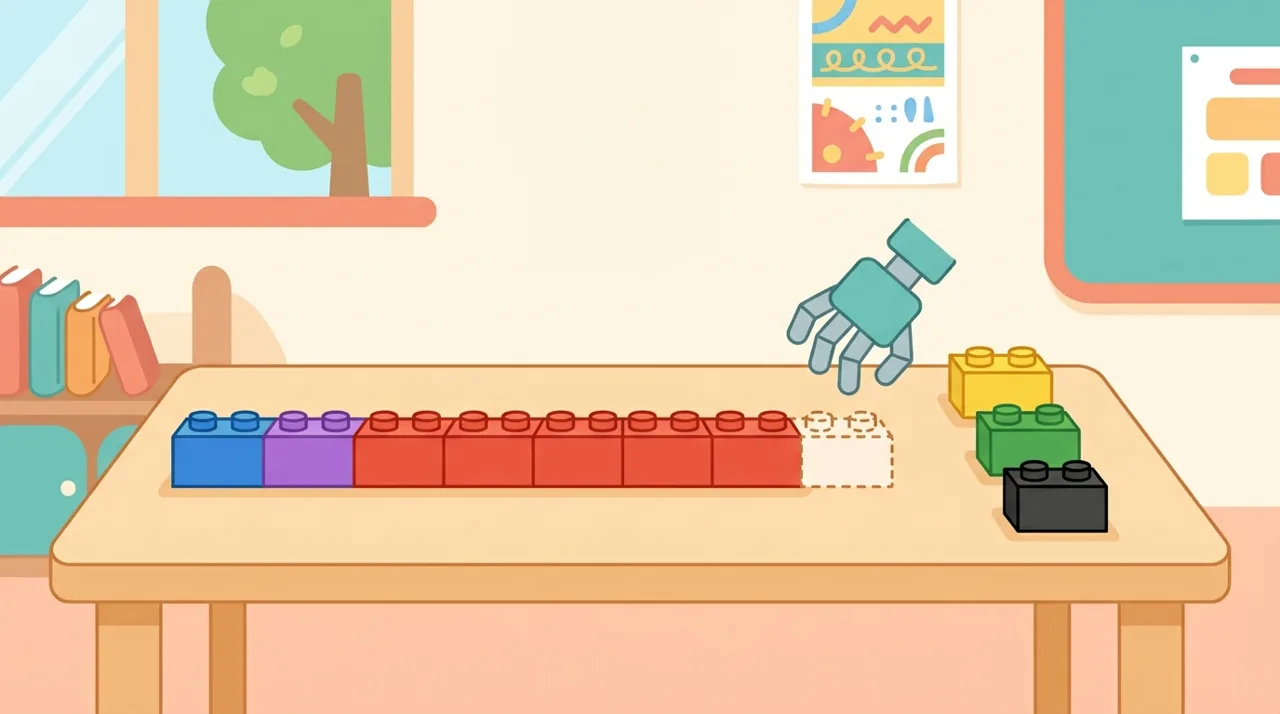
글 AI 가 다음 낱말을 맞혔듯, 음악 AI 는 가사와 스타일을 보면서 다음 소리 조각을 맞힙니다. 노래를 아주 많이 들어서 「이런 가사, 이런 분위기엔 이런 소리」를 알아요.
「그래서 발음이 가끔 뭉개져요 — AI 는 글자가 아니라 소리 조각을 고르니까 비슷한 소리로 미끄러집니다. 짧고 또렷한 가사가 잘 들리는 이유예요.」정직 표기 — 음악 AI 회사는 내부 구조를 공개하지 않았다. 음악 생성 AI 에서 널리 쓰이는 방식으로 설명한 것.
이 장의 목표 — 글 AI 와 «같은 놀이»라는 연결. 조건(가사·스타일)이 앞에 놓인다는 점이 핵심.
📚 진짜 원리 (정확한 말로)
- 음악 생성 모델도 크게 보면 다음 오디오 토큰 예측이다. 다만 «조건»으로 가사 텍스트와 스타일 설명을 앞에 붙인다.
- 앱이 보내는 것: 스타일 문장(글 AI 가 학생 소개+칩을 한 문장으로 정리한 것, 300자 상한) + 가사(학생이 고친 최종본). 허밍을 올린 경우엔 오디오 파일도 같이 간다.
- 노래를 아주 많이 «들으며» 익힌 것 = 가사·장르 설명과 소리 조각의 짝을 학습.
- 왜 발음이 뭉개지나: 모델이 고르는 건 글자가 아니라 소리 조각이라 «비슷한 소리»로 미끄러진다. 짧고 또렷한 문장, 받침 적은 말이 잘 들린다.
- 왜 뒤가 잘리나: AI 가 아니라 앱이 60초에서 자른다. 가사가 길면 뒷줄이 통째로 사라진다 — 8~12줄 지시가 여기서 나온다.
🗣️ 이렇게 진행
학생 노래 하나를 틀고 「가사가 안 들리는 부분 손 들어」. 그 줄을 보면 대개 길거나 받침이 많다. 「AI 가 글자를 고르는 게 아니라 소리를 고르니까 이런 일이 생겨요. 이 줄을 어떻게 고치면 될까?」
❓ 나올 질문과 답
- 「목소리는 누구 목소리예요?」→ 특정 사람이 아니라 «학습한 수많은 목소리의 패턴». 실제 가수 이름을 넣어도 그 사람 목소리를 흉내 내면 안 되고, 앱도 그렇게 쓰지 않는다.
- 「멜로디를 내가 정할 순 없어요?」→ 허밍 올리기가 그 기능. 내 멜로디를 조건으로 넣는 것.
⚠️ 조심할 것
정직 표기 — 이 음악 모델의 내부는 공개돼 있지 않다. 「널리 쓰이는 방식」이라고 말하고, 확실한 것처럼 단정하지 않는다.
C-1. 동네 지도AI 머릿속엔 «동네 지도»가 있다 — 비슷한 건 같은 동네
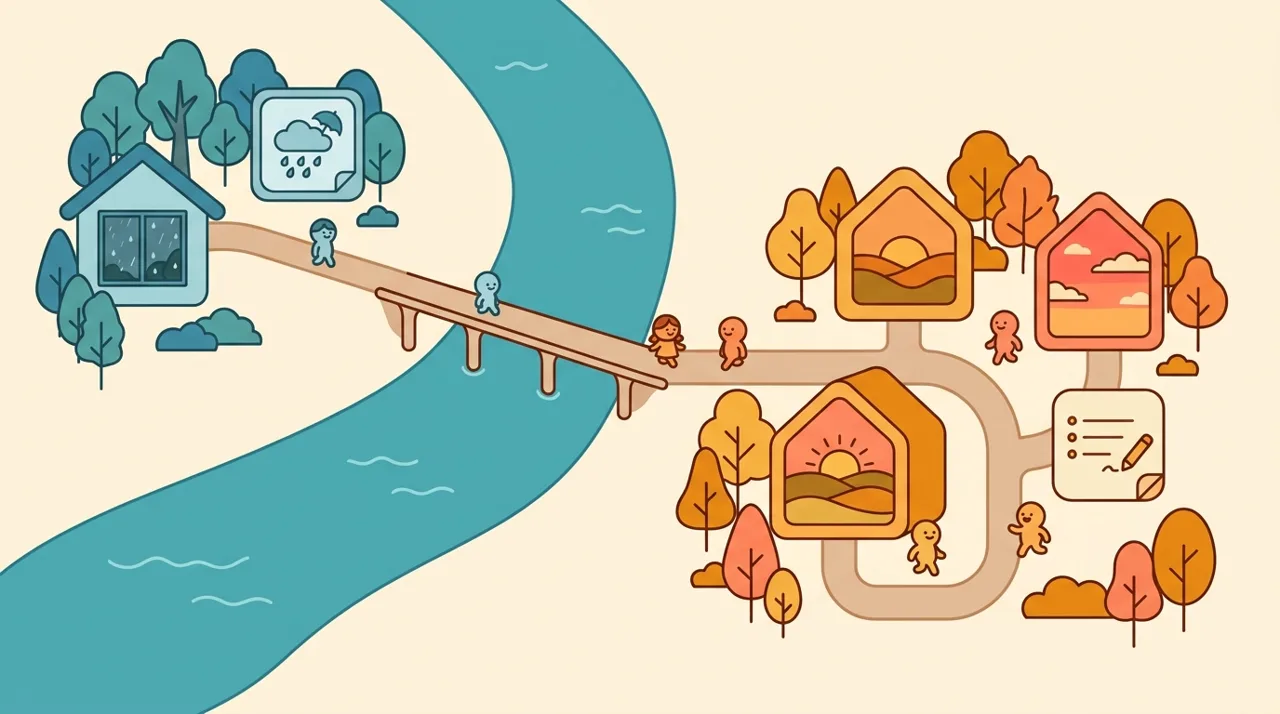
AI 는 사진과 설명을 엄청 많이 보면서 비슷한 건 가까이, 다른 건 멀리 놓는 지도를 만들었어요. 내가 쓴 장면 문장은 그 동네의 주소입니다.
「‘해 질 녘 운동장’이라고 쓰면 AI 는 노을 동네로 가서 그림을 찾아요. 주소가 애매하면 엉뚱한 동네로 갑니다 — 장면 문장을 구체적으로 쓰라는 이유.」
이 장의 목표 — «글과 그림이 같은 지도 위에 있다». 장면 문장 = 주소 라는 비유가 들어가면, 「구체적으로 쓰라」는 지시가 왜 통하는지 이해된다.
📚 진짜 원리 (정확한 말로)
- 정확한 이름: 임베딩(embedding). 글·그림을 숫자 좌표(수백~수천 차원)로 바꾸고, 뜻이 비슷하면 좌표가 가깝게 학습한다.
- 사진과 설명문 쌍을 수억 개 보면서 «이 설명 ↔ 이 그림»이 같은 자리에 오도록 훈련했다. 그래서 문장에서 출발해 그림 쪽으로 갈 수 있다.
- 흔한 조합(노을+운동장)은 동네가 크고 길이 잘 나 있다. 드문 조합(보라색 코끼리가 교실에서 첼로)은 동네가 작아 엉뚱한 곳으로 가기 쉽다 — 12장 «장면 문장과 다르게 나온다»의 이유.
- 앱은 글 AI 가 나눈 5장면 문장을 학생이 다듬게 한 뒤 그림 AI 에 보낸다. 다듬는 단계가 «주소 정확히 쓰기».
🗣️ 이렇게 진행
학생 장면 문장 두 개를 고른다 — 하나는 「친구들」, 하나는 「운동장 구석 벤치에 앉아 이어폰 나눠 끼는 두 친구, 노을」. 「어느 주소가 더 정확해요? AI 가 어느 동네로 갈까요?」
❓ 나올 질문과 답
- 「AI 가 노을이 뭔지 알아요?」→ 노을 «경험»은 없지만 노을 사진·문장이 모인 자리는 안다. 2장 답과 같은 결.
- 「한국말도 알아요?」→ 이 지도는 여러 언어를 같이 배워서 한국어 문장도 같은 동네로 간다. 다만 영어보다 동네가 작을 수 있어 한국 고유 소재(한복·떡볶이)는 가끔 어긋난다.
⚠️ 조심할 것
«지도»를 2차원 종이 지도로 굳히지 말 것. 「실제론 차원이 수백 개라 그릴 수 없고, 우리는 납작하게 그린 것」 한 마디.
C-2. 깎아 내기그림은 한 번에 «짠» 나오지 않고, 흐릿한 데서 조금씩 깎여 나온다
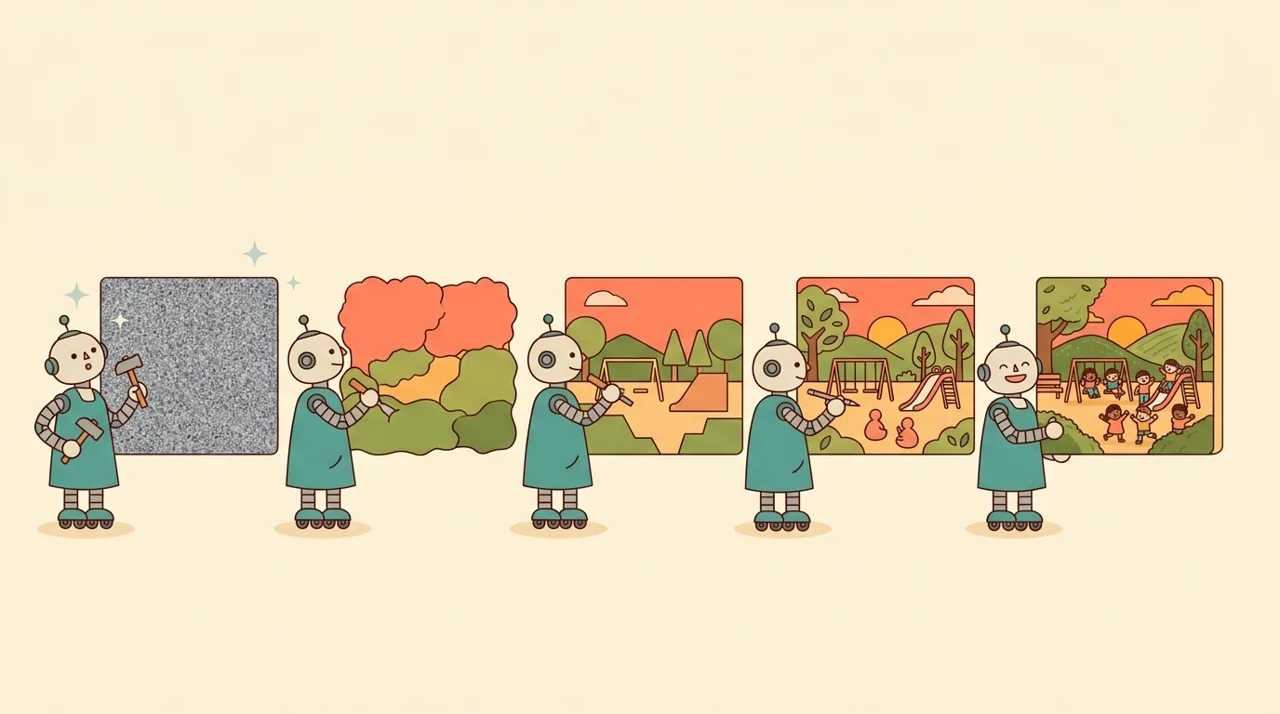
조각가가 돌덩이에서 필요 없는 부분을 깎아 내듯, 그림 AI 는 잡음에서 장면과 안 맞는 부분을 걷어 냅니다. 큰 덩어리 먼저, 세부는 나중.
「그래서 간판 글자가 외계어처럼 나와요 — 글자를 ‘쓰는’ 게 아니라 ‘글자처럼 보이는 무늬’를 깎아 내니까. 제목 글자는 편집실이 AI 없이 따로 얹습니다.」정직 표기 — 그림 AI 회사는 내부 구조를 공개하지 않았다. 그림 생성 AI 의 대표 원리로 설명한 것.
이 장의 목표 — «한 번에 짠이 아니라 단계적으로». 결과가 이상할 때 «주소(문장)를 고치면 된다»로 이어진다.
📚 진짜 원리 (정확한 말로)
- 대표 방식 1: 확산(diffusion) — 잡음 그림에서 시작해 «장면 문장에 맞도록» 잡음을 조금씩 걷어낸다(수십 단계). 슬라이드 그림은 이것.
- 대표 방식 2: 자기회귀(autoregressive) — 그림을 조각(이미지 토큰)으로 나눠 글 AI 처럼 차례로 맞힌다. 이 앱이 쓰는 모델은 둘 중 어느 쪽인지 회사가 공개하지 않았다.
- 둘 다 «큰 구도 먼저, 세부 나중»이라는 점은 같다. 학생에겐 이 공통점만.
- 앱이 보내는 지시: 「어린이 뮤직비디오의 한 장면 / 장면: ○○ / 참고 이미지 우선 / 참고가 없을 때 분위기: ○○ / 글자·로고 없이 가로 16:9 한 장」. 그림을 못 받으면 최대 3번 다시 시도한다.
- 글자가 깨지는 이유: 모델은 글자를 «쓰는» 게 아니라 «글자처럼 보이는 무늬»를 그린다. 그래서 제목·이름 글자는 편집실이 AI 없이 얹는다.
🗣️ 이렇게 진행
학생 그림 중 이상한 것(손가락 6개·간판 외계어)을 하나 띄운다(본인 동의). 「AI 가 실수한 게 아니라 원래 이렇게 만들어진 기계예요. 조각가가 돌덩이에서 안 맞는 부분을 깎아 내는데, 손가락 개수는 사진마다 가려져 있어서 단서가 약해요.」
❓ 나올 질문과 답
- 「손가락은 왜 틀려요?」→ 학습 사진 속 손은 겹치고 가려진 게 많아 «몇 개»를 셀 단서가 약하다.
- 「그림 다시 만들기 20번 다 써도 돼요?」→ 되지만, 문장을 안 고치고 다시 누르면 같은 동네에서 주사위만 굴리는 것. 문장을 고치는 게 먼저.
⚠️ 조심할 것
정직 표기 — 확산이라고 단정하지 말 것. 「그림 AI 가 많이 쓰는 방식 중 하나」.
C-3. 참고 그림웹툰 작가처럼 «캐릭터 설정화»를 옆에 붙여 두고 그린다
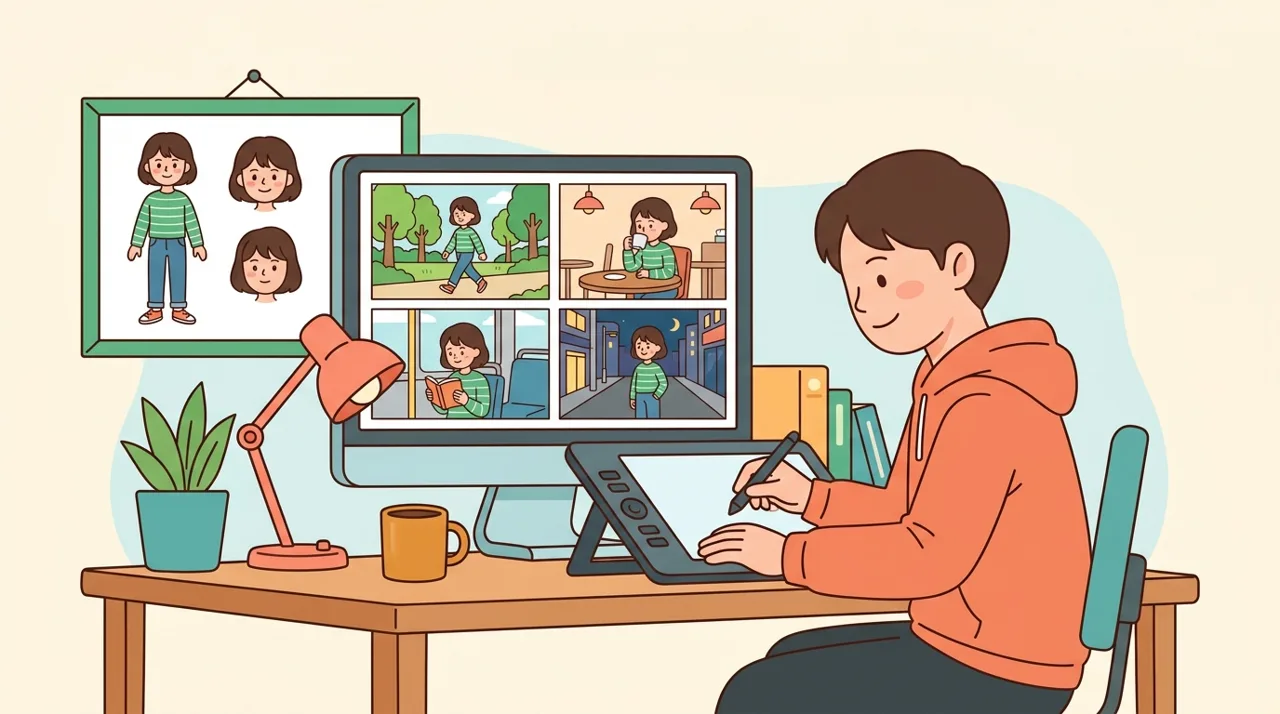
AI 는 장면마다 새로 그리기 때문에 그냥 두면 주인공 얼굴이 매번 바뀝니다. 그래서 앱은 기준 컷을 참고 그림으로 같이 넣어요. 기준 컷 뒤에 분위기 칩이 잠기는 것도 이 때문.
「웹툰 작가가 캐릭터 설정화를 모니터 옆에 붙여 두고 그리는 것과 똑같아요.」
이 장의 목표 — 앱의 «기준 컷» 설계 이유를 이해시키기. 왜 기준 컷 뒤에 분위기 칩이 잠기는지까지 가면 성공.
📚 진짜 원리 (정확한 말로)
- 그림 AI 는 호출마다 «기억 없이» 새로 그린다. 5번 부르면 주인공이 5명이 된다.
- 해결: 첫 그림(기준 컷)을 참고 이미지로 함께 보내고 「등장인물·화풍·색감은 참고 이미지를 최우선으로」라고 지시한다. 앱은 참고 그림을 최대 3장까지 넣는다.
- 분위기 칩(6종)이 기준 컷 뒤에 잠기는 이유: 글 지시와 참고 그림이 서로 다른 말을 하면 참고 그림이 밀린다. 그래서 앱은 분위기 텍스트를 «참고 그림이 없을 때만»으로 강등했다.
- 학생이 «내 그림 업로드»로 기준을 바꾸면 그 그림이 참고가 된다 — 옛 스타일이 이어지지 않도록 만든 설계.
🗣️ 이렇게 진행
학생 5컷 중 얼굴이 잘 이어진 것과 안 이어진 것을 나란히 띄운다. 「차이가 뭘까요?」 → 기준 컷을 잘 잡았는가. 「웹툰 작가는 설정화를 옆에 붙여 두죠. AI 에게도 똑같이 붙여 줘야 해요.」
❓ 나올 질문과 답
- 「기준 컷 마음에 안 드는데 분위기 못 바꿔요?」→ 기준 컷을 다시 만들면 된다. 잠긴 건 «기준을 둔 뒤»뿐.
- 「참고 그림 넣었는데도 바뀌어요」→ 참고는 «최우선으로 따르라는 부탁»이지 보장이 아니다(3장 주사위). 얼굴이 크게 나온 기준 컷일수록 잘 이어진다.
⚠️ 조심할 것
«참고 그림 = 복사»가 아님을 짚는다. 참고를 보고 «새로 그린다» — 그래서 조금씩은 달라진다.
D-1. 플립북영상은 플립북 — 첫 장은 내 그림, 나머지는 AI 가 그린다
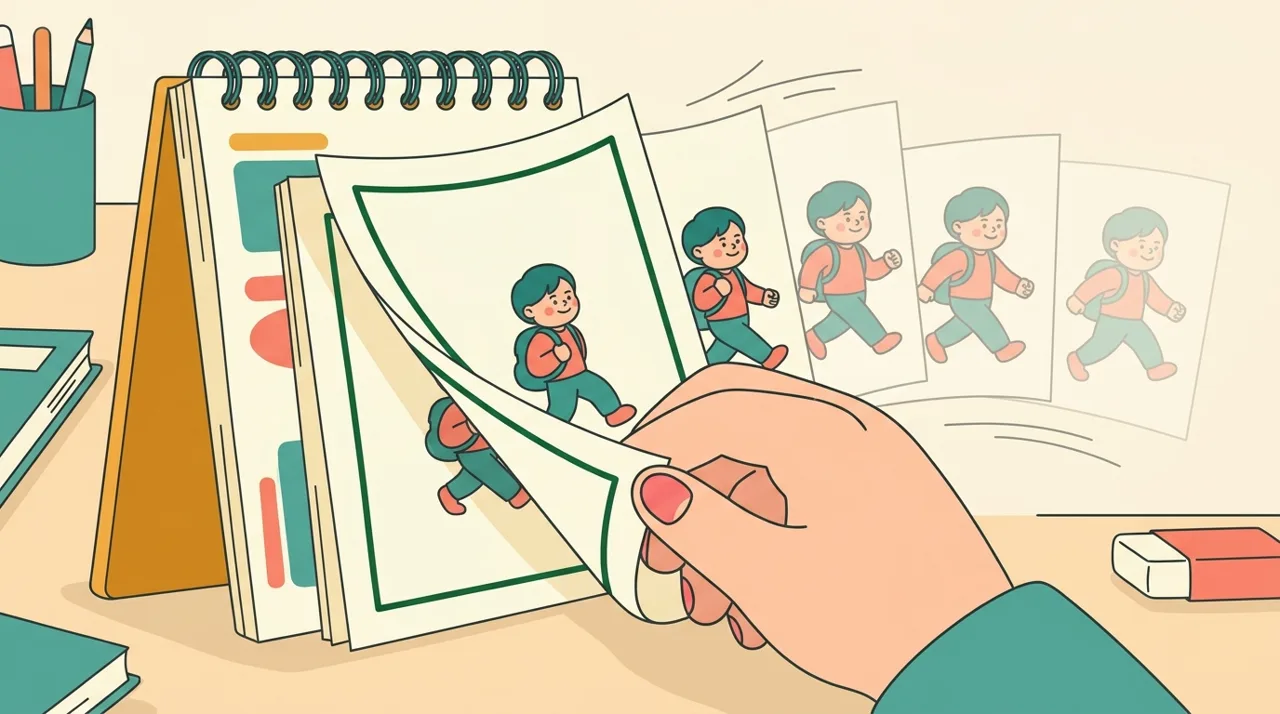
영상 AI 는 내 그림을 첫 장으로 두고 「다음 순간엔 어떻게 변할까?」를 맞혀 다음 장을 그립니다. 그림 AI 보다 백 배 많이 그려야 해서 느리고, 횟수가 10회로 정해져 있어요.
「컷 하나에 2~3분 걸리는 이유가 이거예요. 한 장이 아니라 백 장 넘게 그리니까.」정직 표기 — 영상 AI 회사는 내부 구조를 공개하지 않았다. 영상 생성 AI 의 대표 원리로 설명한 것.
이 장의 목표 — «영상 = 그림 여러 장» + «첫 장만 내 것». 왜 느리고 횟수가 정해졌는지 이해시키기.
📚 진짜 원리 (정확한 말로)
- 5초 영상 = 초당 24장 × 5 = 120장. 영상 AI 는 첫 장(내 그림)을 조건으로 나머지 장을 «다음 순간»으로 생성한다(image-to-video).
- 실제로는 120장을 따로 그리는 게 아니라 «시간 축까지 포함한 덩어리»를 한 번에 깎아 낸다 — 그래도 그림 한 장보다 계산이 수십~수백 배.
- 그래서 컷 하나에 2~3분, 편당 비용이 그림보다 훨씬 크다. 앱이 10회로 제한한 이유. 실패해도 재시도 없이 그 컷만 실패하고 횟수는 준다 — 연타 금지.
- 앱은 그림·장면 문장·5초를 보내고, 결과 mp4 를 받아 편집실에 넣는다.
🗣️ 이렇게 진행
공책 귀퉁이 플립북을 실제로 하나 만들어 온다(또는 학생에게 쉬는 시간에 그리게). 「이거 몇 장 그렸어요? 8장? AI 는 5초에 120장.」 → 「그래서 2분 걸리고, 10번뿐이에요.」
❓ 나올 질문과 답
- 「왜 5초밖에 안 돼요?」→ 10장 귓속말로.
- 「내 그림이랑 좀 달라졌어요」→ 첫 장은 그대로지만 2장부터는 AI 가 «지어낸» 것. 크게 어긋나면 그림을 단순하게(인물 하나·배경 단순) 바꿔 다시.
⚠️ 조심할 것
«백 장을 그린다»는 비유. 정확히는 한 덩어리로 생성한다. 학생이 파고들면 「한 번에 뭉텅이로 깎아 내는데, 양이 백 장치」.
D-2. 귓속말왜 5초일까 — 귓속말 전달 놀이처럼 길수록 처음에서 멀어진다
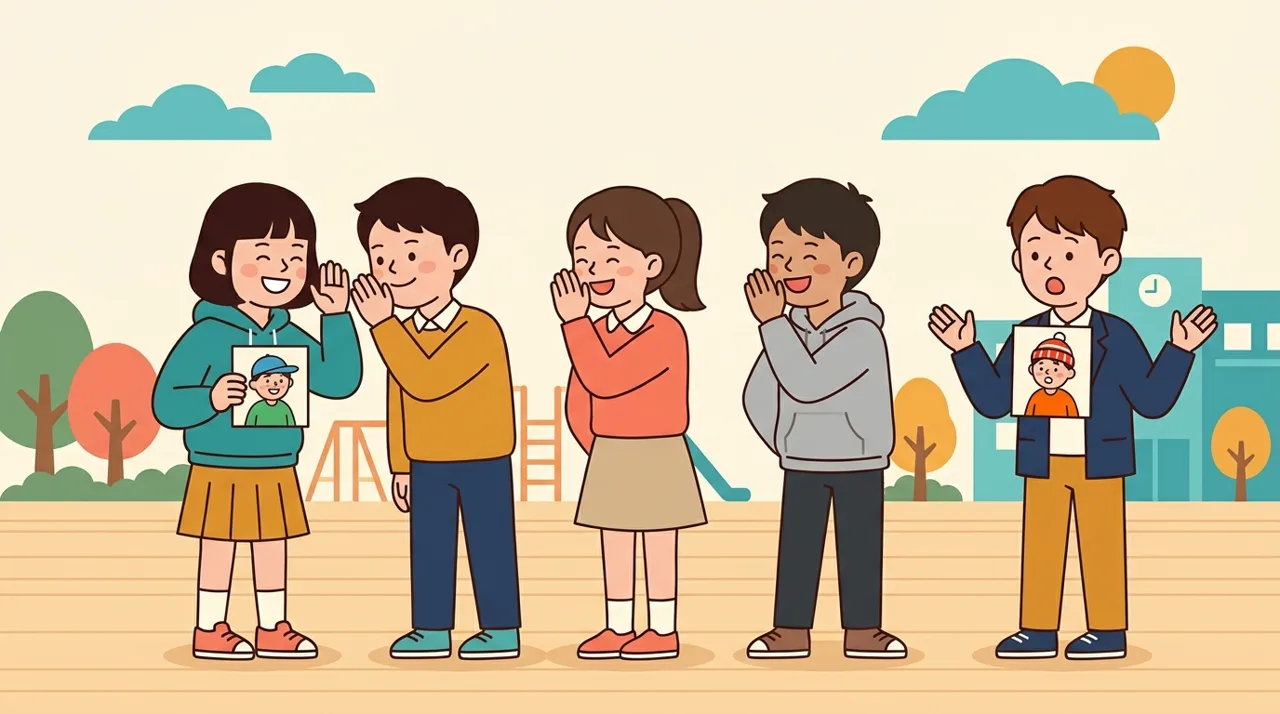
AI 는 앞 장만 보고 다음 장을 그려요. 그래서 길어질수록 처음 그림에서 멀어집니다. 뮤직비디오를 짧은 컷 여러 개로 나누고, 컷마다 내 그림으로 다시 붙잡는 이유예요.
「귓속말 전달 놀이 해 봤죠? 사람이 많을수록 말이 바뀌어요. 영상 AI 도 똑같습니다.」
이 장의 목표 — «길수록 처음에서 멀어진다» 한 줄. 뮤직비디오를 짧은 컷으로 나누는 설계가 이 한계 때문임을 잇는다.
📚 진짜 원리 (정확한 말로)
- 영상 AI 는 앞 장면을 보고 다음을 지어낸다. 작은 어긋남(옷 색·배경)이 장마다 쌓여 오차 누적이 생긴다. 길수록 첫 그림에서 멀어진다.
- 그래서 상용 모델들도 5~10초 단위로 만든다. 앱은 컷당 5초를 쓰고, 컷마다 «내 그림»으로 다시 붙잡는다(각 컷의 첫 장이 학생 그림).
- 0~2초는 안정, 3~5초부터 새로 지어내는 비율이 커진다. 얼굴이 바뀌는 건 대개 뒷부분.
🗣️ 이렇게 진행
귓속말 전달 놀이를 5명으로 실제로 한다(문장 하나). 마지막 학생이 말한 걸 칠판에 쓰고 원문과 비교. 「사람이 늘수록 멀어지죠? 영상 AI 도 장이 늘수록 멀어져요. 그래서 5초.」
❓ 나올 질문과 답
- 「1분짜리를 한 번에 만들면 안 돼요?」→ 만들 수는 있지만 끝에 가면 다른 사람이 된다. 그래서 컷으로 나누고 노래로 잇는다.
- 「AI 영상 안 쓰고 다 줌·팬으로 하면요?」→ 된다. 11장.
⚠️ 조심할 것
«기억이 흐려진다»는 비유. AI 에 «기억»이 있는 건 아니다 — 앞 장을 보고 다음을 만드는 구조라 어긋남이 쌓이는 것.
D-3. AI 가 아닌 것줌·팬은 AI 가 아니다 — 그래서 무료이고 바로 된다
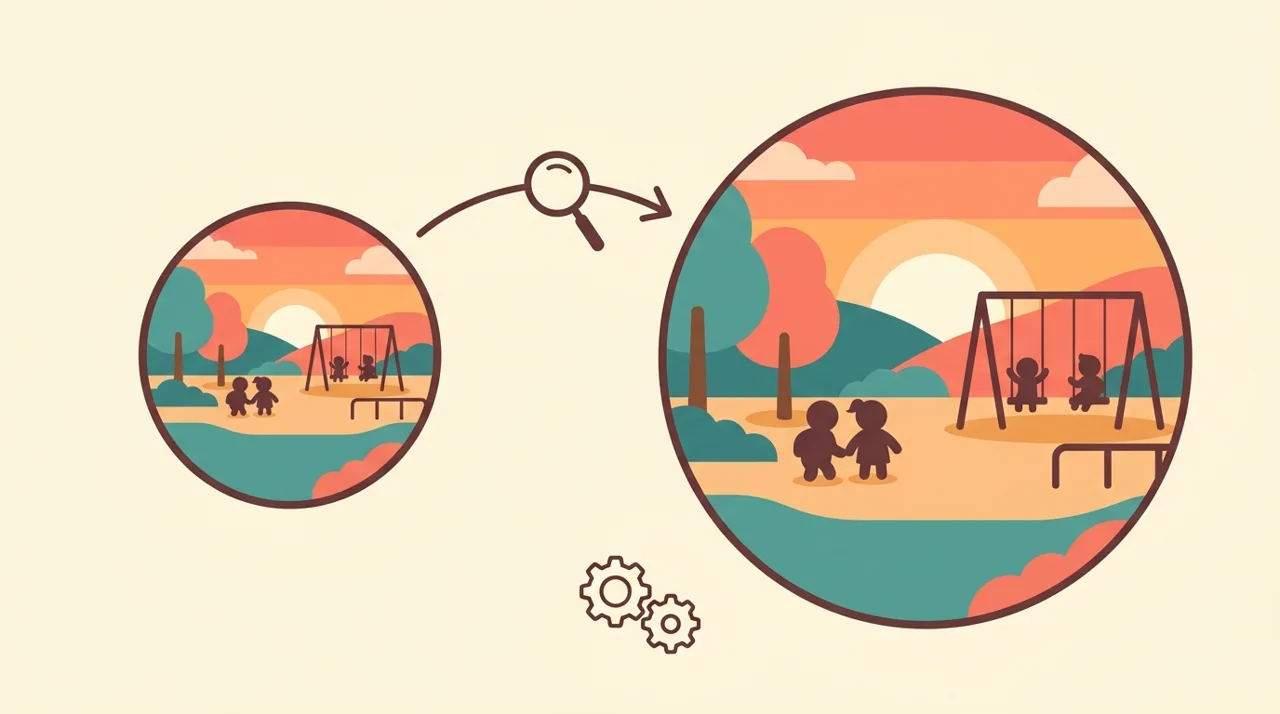
줌·팬은 있는 그림을 계산으로 움직이는 것이라 항상 같고, 무료이고, 바로 됩니다. AI 영상은 새 장면을 지어내는 것이라 매번 다르고, 기다려야 해요.
「모든 컷에 AI 영상을 쓸 필요 없어요. 움직임이 꼭 필요한 컷에만 AI, 나머지는 줌·팬. 이게 진짜 감독의 선택입니다.」
이 장의 목표 — «AI 인 것 / 아닌 것»을 가르는 기준을 손에 쥐어 주기: 같은 입력에 항상 같은 결과가 나오면 계산, 매번 다르면 AI.
📚 진짜 원리 (정확한 말로)
- 줌인·줌아웃·팬 = 켄 번스(Ken Burns) 효과. 편집실(ffmpeg)이 «있는 그림»의 확대율·위치를 시간에 따라 계산으로 바꾼다. 새로 그리는 게 없다.
- 그래서 무료·즉시·항상 같은 결과. 전환(어두워졌다 밝게)·제목 카드·끝 카드·노래 합치기·720p 출력도 전부 이쪽.
- AI 영상: 새 장면을 «지어내는» 것 — 매번 다르고, 기다리고, 횟수 제한.
- 수업 판단: 시간이 모자라면 컷 1·5만 AI 영상, 나머지는 줌·팬(H3 교안과 같은 규칙). 원리를 알면 이 선택이 «타협»이 아니라 «감독의 선택»이 된다.
🗣️ 이렇게 진행
같은 컷을 줌인으로 두 번 만들어 보인다 → 완전히 같다. AI 영상을 두 번 → 다르다. 「이게 AI 와 계산의 차이예요. 여러분 영상에서 어디에 AI 를 쓸지 정해 보세요.」
❓ 나올 질문과 답
- 「줌·팬도 AI 로 하면 더 좋지 않아요?」→ 카메라 움직임만 필요하면 계산이 더 정확하고 빠르다. AI 는 «그림 속 인물이 움직여야» 할 때만 값어치가 있다.
⚠️ 조심할 것
«AI 가 아니라서 급이 낮다»로 들리지 않게. 영화도 대부분의 컷은 카메라 움직임이다.
E. 생각해 보기AI 와 «함께» 만든 내 뮤직비디오 — 내가 한 일은 뭘까
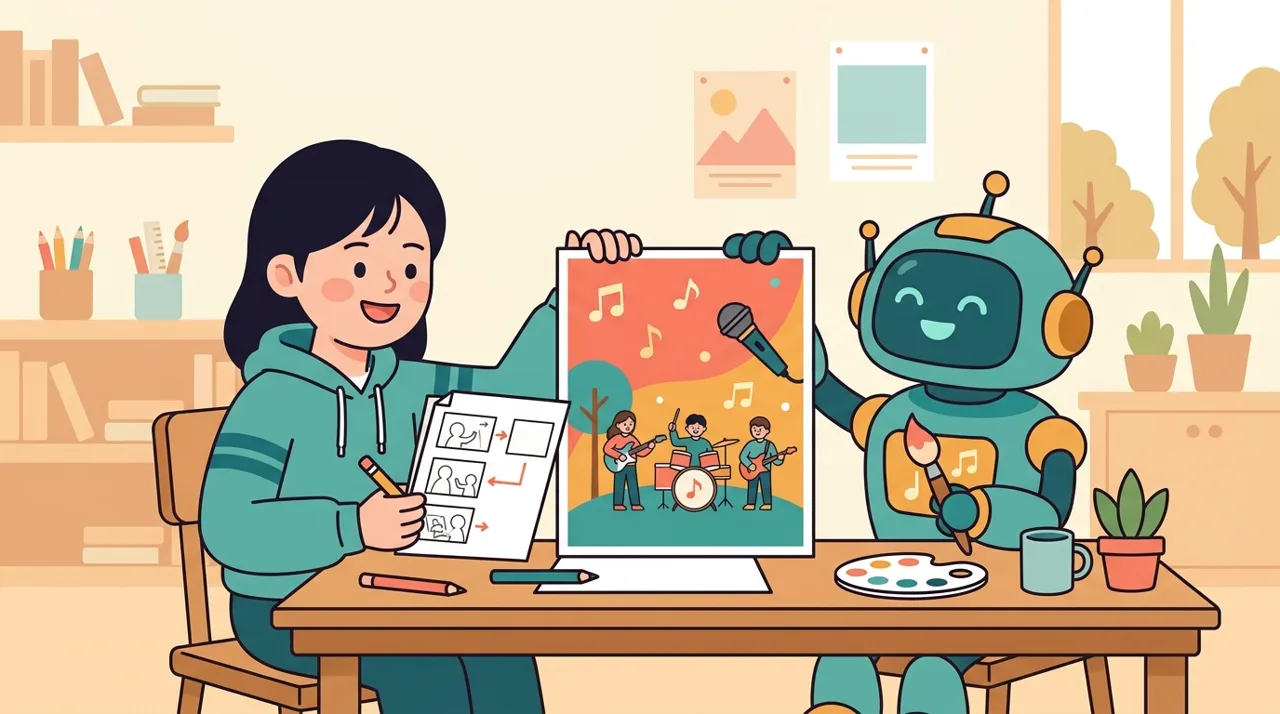
네 AI 는 전부 사람이 만든 글·노래·그림을 보고 배운 것이에요. 그리고 주제 고르기·가사 고치기·장면 정하기·컷 배치는 내가 한 일입니다. 모둠에서 「내가 한 일 3가지」를 적어 봅시다.
Q1. 다시 만들면 왜 가사가 달라져?
AI 가 1등 카드만 고르지 않고 주사위를 굴리니까 (3장).
Q2. 5장면 주인공 얼굴이 같은 비결은?
기준 컷을 참고 그림으로 같이 넣으니까 (8장).
Q3. 줌·팬은 무료인데 AI 영상은 왜 10번뿐?
줌·팬은 계산, AI 영상은 백 장 넘게 새로 그리니까 (9·11장).
「정답 없는 질문이에요. 실제 사람 얼굴·이름을 넣으면 그 사람이 안 한 일을 한 것처럼 보일 수 있다는 것도 같이 이야기해 보세요. 완성 영상엔 참여 이름이 자동으로 들어갑니다.」확인 필요 — AI 생성물 저작권은 나라·약관마다 다르고 바뀌는 중. 수업에서는 «생각해 볼 질문»으로만.